
封装大战核心!台积电 System Scaling:CoWoS、Chiplet、3D 封装全梳理
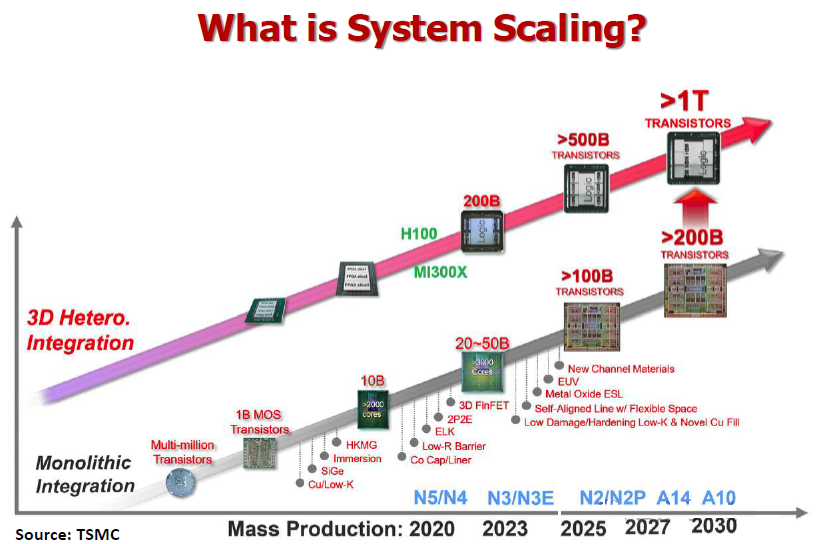
摩尔定律放缓,性能增长从晶体管缩放转向系统级集成
HBM、Chiplet与3D封装协同演进,重构算力底层架构
最近在看台积电 这份 关于System Scaling 的技术分享时,我有一个越来越强烈的感受——
半导体行业,正在经历一次“从晶体管到系统”的范式切换。
过去几十年,我们习惯了一条几乎不用怀疑的路径:只要制程节点持续演进,晶体管越做越小,性能自然提升、成本逐步下降。但当我把3nm之后的技术、AI算力需求,以及整个系统架构放在一起看时,会发现一个越来越清晰的现实:
这套以“缩尺寸”为核心的逻辑,已经开始失效。
一方面,晶体管还在进步,但设计成本在指数级上升,性能提升却越来越依赖复杂的工程手段;
另一方面,真正限制系统性能的,已经不再是计算本身,而是带宽、互连以及功耗与散热这些“系统级问题”。
也正是在这样的背景下,System Scaling开始走到台前——
从Chiplet拆分,到2.5D/3D封装,再到逻辑与HBM的深度集成,行业正在尝试用一种全新的方式,继续推动性能的增长。
换句话说,
半导体不再只是“把晶体管做小”,而是“把系统做对”。
而这,才是这份报告真正想讲清楚的核心变化。
一、这份材料真正想说明什么?
当摩尔定律放缓之后,半导体性能提升的核心路径,正在从“晶体管缩放”转向“系统级集成(System Scaling)”。
二、最核心转折:摩尔定律正在失效
文档一开始就点明:
• 晶体管几何缩放已经放缓
• 行业进入“等效缩放”(靠设计/材料/工艺补偿)
同时:
• 设计成本随节点急剧上升 核心结论:
“继续缩小晶体管”这条路,已经越来越难、越来越贵
三、关键替代路径:System Scaling登场
👉 TSMC直接给出判断:
👉 Moore’s Law slows down → System Scaling came to rescue System Scaling本质是什么?
👉 不再只优化晶体管,而是优化整个系统:
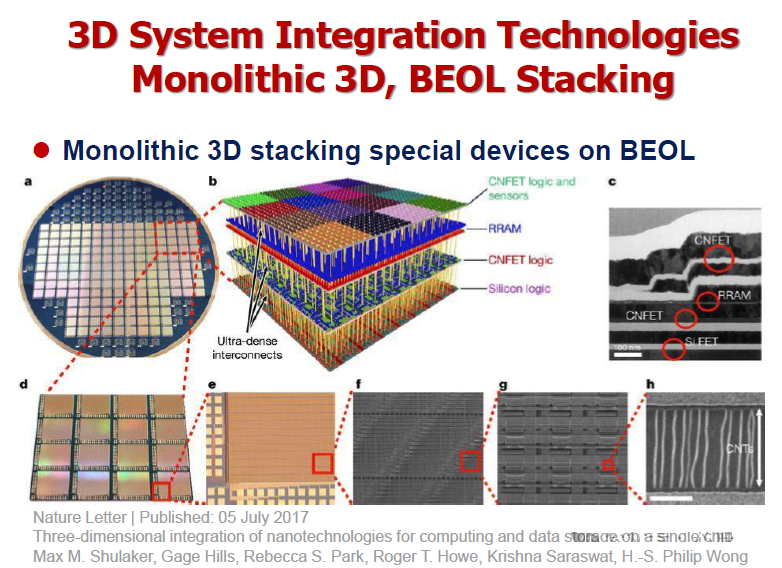
• SoC拆分(Chiplet)
• 封装集成(SoP)
• 架构协同(PPAC)
核心结论:
性能提升,从“器件问题”变成“系统问题”
四、为什么必须走这条路:AI带来的三大瓶颈
1️⃣ 带宽墙(最关键)
• AI模型增长:410× / 2年
• 内存带宽:仅 2× / 2年
👉 结论:
算力增长远快于带宽 → 系统瓶颈出现
2️⃣ 互连成为核心限制
• FLOPS增长 >> DRAM带宽 >> 互连带宽
👉 结论:
真正卡住性能的,是“连接”,不是“计算”
3️⃣ 功耗与散热(被严重低估)
• 数据中心:
👉 40%电力用于散热
核心结论:
未来芯片设计,本质是“带宽 + 功耗 + 热”的系统平衡
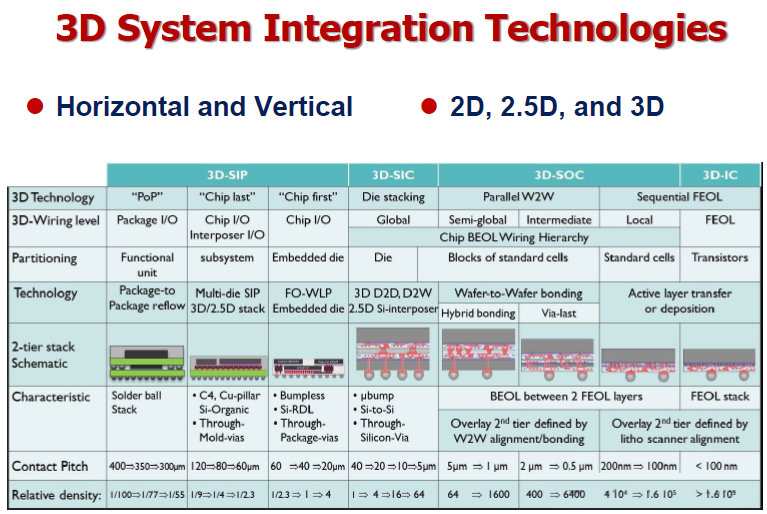
五、System Scaling的核心手段:从2D走向3D
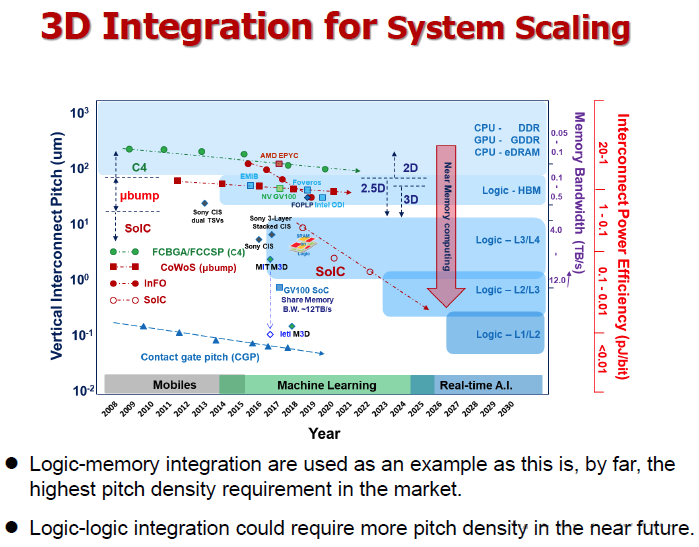
从:2D(单芯片)到:
• 2.5D(interposer)
• 3D(垂直堆叠)
带来巨大变化:
• 互连距离 ↓ 1000倍
• 互连密度 ↑ 1000倍
• 通信效率 ↑ 百万级
本质:
把“远距离通信”变成“近距离连接”
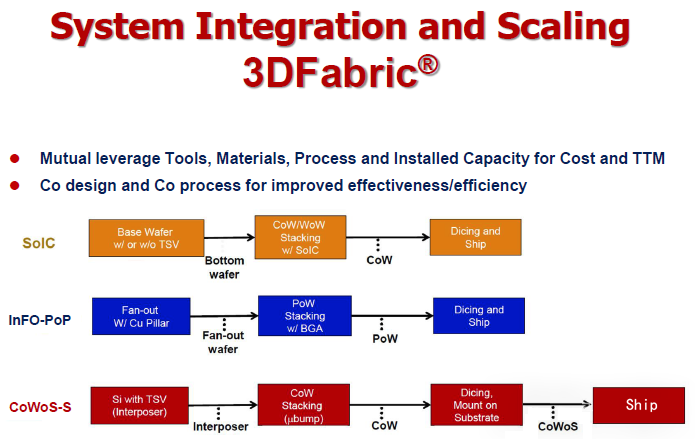
六、技术实现路径:先进封装成为核心
TSMC 台积电 给出的完整体系:
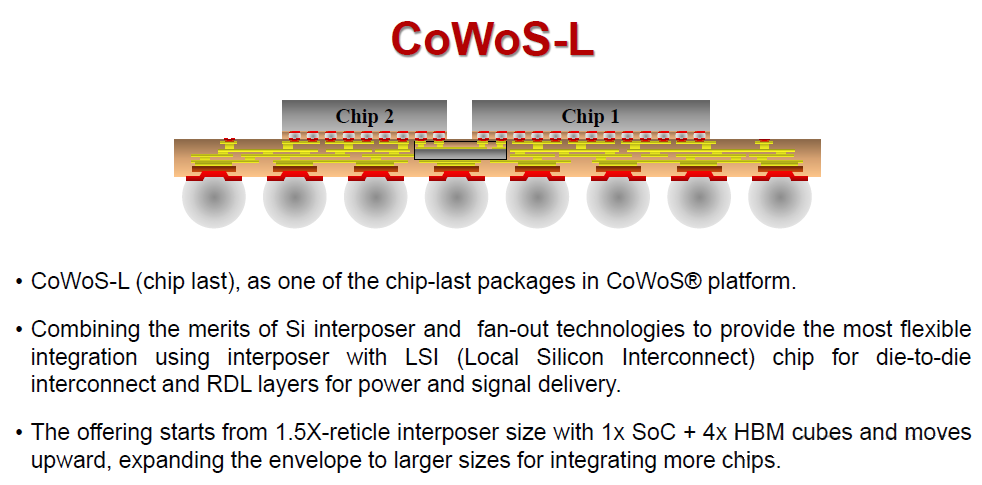
🔷 2.5D:
• CoWoS(HBM + GPU核心)
🔷 Fan-out:
• InFO(移动/高集成)
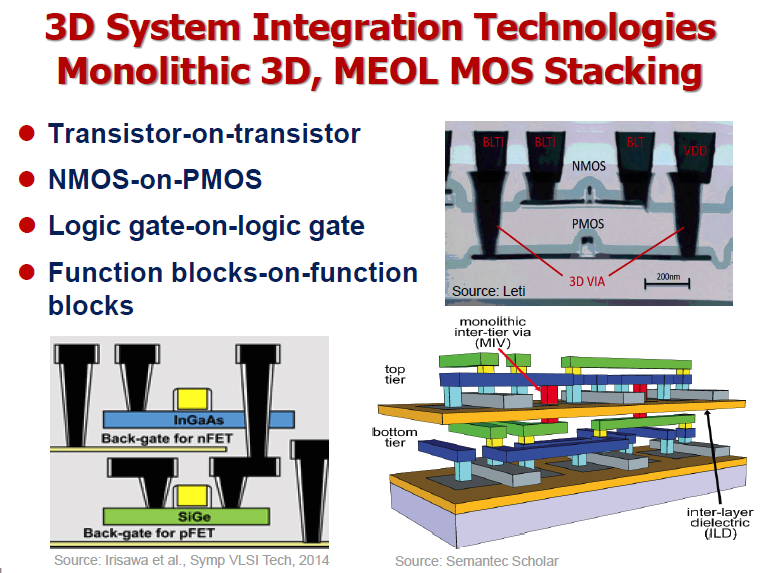
🔷 3D:
• SoIC(真正垂直堆叠)
核心结论:
先进封装 = 新时代“性能提升工具”
七、更深一层本质:从“芯片设计”走向“系统设计”
文档反复强调:
• PPAC(性能/功耗/面积/成本)
• Chiplet拆分
• 异构集成(逻辑+存储+光子)
核心变化:
过去 现在 单芯片优化 多芯片系统优化 工艺驱动 架构+封装驱动 缩尺寸 拼系统
本质结论:
芯片已经不再是产品,系统才是产品
🏁小编总结
半导体的“Scaling”,正在从“Transistor Scaling”升级为“System Scaling”。